CSVとParquetのデータ比較
データ分析にはParquetのほうが良いとは言いますが、実際のところはどうなのか、書き込み速度、読み込み速度、ファイルサイズ、Athenaでのクエリを比較しました。
コマンドの実行はCloudShellで実行しました。
目次
環境準備
データ分析ライブラリのpandasとParquetフォーマットを扱うためのpyarrowをインストールしました。
|
1 2 |
pip3 install pandas pyarrow |
検証用のS3バケットを作成しました。
|
1 2 3 |
BUCKET="data-handson-$(aws sts get-caller-identity --query Account --output text)" aws s3 mb s3://${BUCKET} |
CSVとParquetデータ作成とローカルでの比較
次のPythonファイルをvimでdata_compare.pyとして作成しました。
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 |
import pandas as pd import numpy as np import time import os # テストデータ生成(100万行) np.random.seed(42) n = 1_000_000 df = pd.DataFrame({ 'order_id': range(n), 'customer_id': np.random.randint(1, 10000, n), 'product_category': np.random.choice(['Electronics', 'Clothing', 'Food', 'Books'], n), 'price': np.random.lognormal(7, 1.5, n).round(2), 'quantity': np.random.randint(1, 20, n), 'order_date': pd.date_range('2023-01-01', periods=n, freq='s'), 'region': np.random.choice(['Tokyo', 'Osaka', 'Fukuoka', 'Sapporo', 'Nagoya'], n), }) # --- CSV --- start = time.time() df.to_csv('/tmp/data.csv', index=False) csv_write_time = time.time() - start csv_size = os.path.getsize('/tmp/data.csv') start = time.time() pd.read_csv('/tmp/data.csv') csv_read_time = time.time() - start # --- Parquet --- start = time.time() df.to_parquet('/tmp/data.parquet', index=False) parquet_write_time = time.time() - start parquet_size = os.path.getsize('/tmp/data.parquet') start = time.time() pd.read_parquet('/tmp/data.parquet') parquet_read_time = time.time() - start # --- Parquet (特定列のみ読み込み) --- start = time.time() pd.read_parquet('/tmp/data.parquet', columns=['price', 'quantity']) parquet_cols_time = time.time() - start # 結果比較 print("=" * 60) print(f"{'形式':<12} {'サイズ(MB)':<12} {'書込(秒)':<10} {'全読込(秒)':<12} {'列読込(秒)':<10}") print("=" * 60) print(f"{'CSV':<12} {csv_size/1024/1024:<12.1f} {csv_write_time:<10.2f} {csv_read_time:<12.2f} {'N/A':<10}") print(f"{'Parquet':<12} {parquet_size/1024/1024:<12.1f} {parquet_write_time:<10.2f} {parquet_read_time:<12.2f} {parquet_cols_time:<10.2f}") print("=" * 60) print(f"\nサイズ比: Parquet は CSV の {parquet_size/csv_size*100:.1f}% のサイズ") print(f"列選択読込: Parquet は全読込の {parquet_cols_time/parquet_read_time*100:.1f}% の時間") |
実行しました。
|
1 2 |
python3 data_compare.py |
結果です。
| 形式 | サイズ(MB) | 書込(秒) | 全読込(秒) | 列読込(秒) |
|---|---|---|---|---|
| CSV | 54.1 | 3.39 | 1.13 | |
| Parquet | 18.3 | 0.29 | 0.29 | 0.03 |
サイズ比: Parquet は CSV の 33.8% のサイズ
列選択読込: Parquet は全読込の 9.3% の時間
Parquetのほうがサイズも小さく書き込み読み込みも早い結果となりました。
Athenaでのクエリ比較
データをS3バケットへアップロード
|
1 2 3 |
aws s3 cp /tmp/data.csv s3://${BUCKET}/formats/csv/data.csv aws s3 cp /tmp/data.parquet s3://${BUCKET}/formats/parquet/data.parquet |
ここからはAthenaクエリエディタで実行しました。
S3バケット名は変更してください。
データベースの作成
|
1 2 |
CREATE DATABASE IF NOT EXISTS data_handson; |
CSV向けテーブルの作成
|
1 2 3 4 5 6 7 |
CREATE EXTERNAL TABLE data_handson.csv_sales ( order_id INT, customer_id INT, product_category STRING, price DOUBLE, quantity INT, order_date STRING, region STRING ) ROW FORMAT DELIMITED FIELDS TERMINATED BY ',' LOCATION 's3://data-handson-123456789012/formats/csv/' TBLPROPERTIES ('skip.header.line.count'='1'); |
Parquet向けテーブルの作成
|
1 2 3 4 5 6 |
CREATE EXTERNAL TABLE data_handson.parquet_sales ( order_id INT, customer_id INT, product_category STRING, price DOUBLE, quantity INT, order_date TIMESTAMP, region STRING ) STORED AS PARQUET LOCATION 's3://data-handson-123456789012/formats/parquet/'; |
それぞれのクエリで比較しました。
|
1 2 3 |
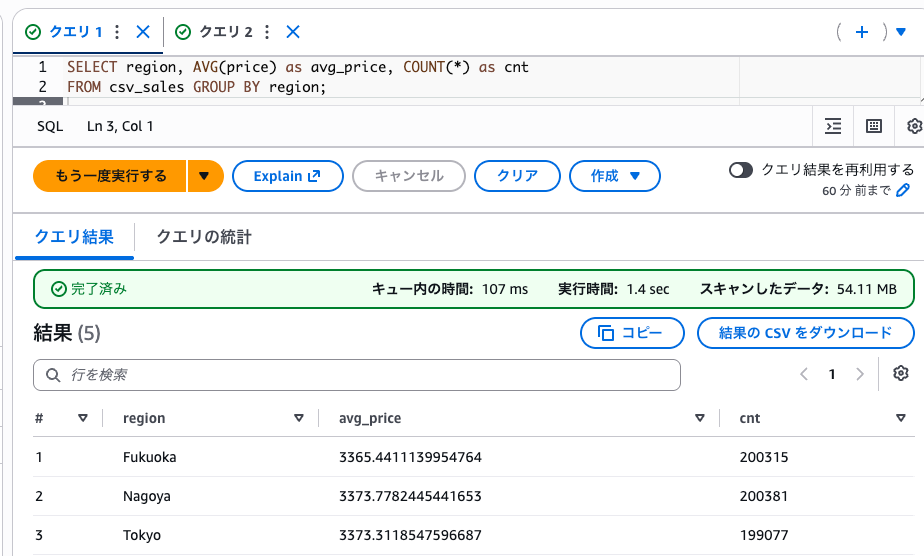
SELECT region, AVG(price) as avg_price, COUNT(*) as cnt FROM data_handson.csv_sales GROUP BY region; |
|
1 2 3 |
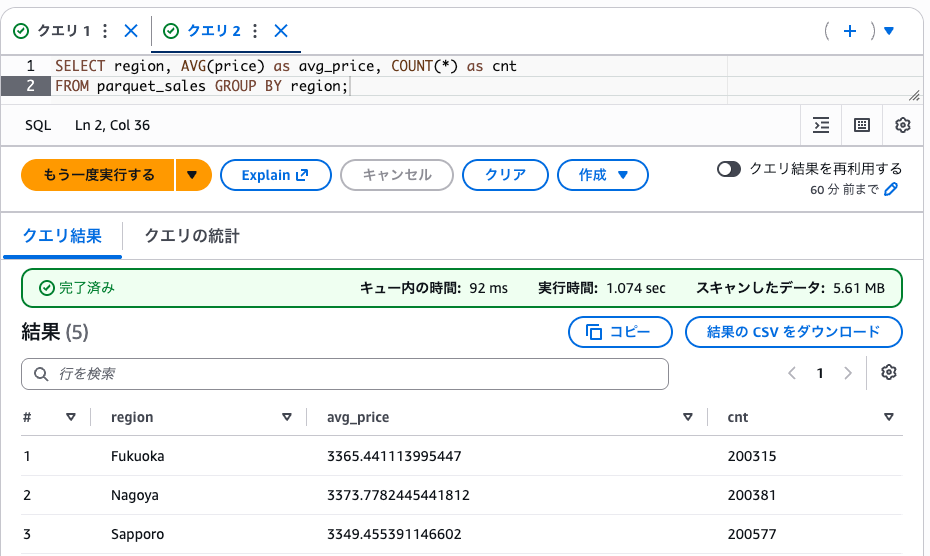
SELECT region, AVG(price) as avg_price, COUNT(*) as cnt FROM data_handson.parquet_sales GROUP BY region; |
結果です。
CSV
Parquet
CSVはスキャンしたデータが54.11MBで実行時間は1.4秒でした。
Parquetはスキャンしたデータが5.61MBで実行時間は1.074秒でした。
Parquetはクエリに必要な列だけをスキャンしたので、コスト効率が良い結果となりました。
最後までお読みいただきましてありがとうございました!
「AWS認定資格試験テキスト&問題集 AWS認定ソリューションアーキテクト - プロフェッショナル 改訂第2版」という本を書きました。
「AWS認定資格試験テキスト AWS認定クラウドプラクティショナー 改訂第3版」という本を書きました。
「AWS認定資格試験テキスト AWS認定AIプラクティショナー」という本を書きました。
「AWS教科書 AWS認定デベロッパーアソシエイト テキスト&問題集 」という本を書きました。
「要点整理から攻略するAWS認定ソリューションアーキテクト-アソシエイト」という本を書きました。
「AWSではじめるLinux入門ガイド」という本を書きました。

開発ベンダー5年、ユーザ企業システム部門通算9年、ITインストラクター5年目でプロトタイプビルダーもやりだしたSoftware Engineerです。
質問はコメントかSNSなどからお気軽にどうぞ。
出来る限りなるべく答えます。
このブログの内容/発言の一切は個人の見解であり、所属する組織とは関係ありません。
このブログは経験したことなどの共有を目的としており、手順や結果などを保証するものではありません。
ご参考にされる際は、読者様自身のご判断にてご対応をお願いいたします。
また、勉強会やイベントのレポートは自分が気になったことをメモしたり、聞いて思ったことを書いていますので、登壇者の意見や発表内容ではありません。

関連記事
-
-
Feedlyのリフレッシュトークンを使ってアクセストークンを取得する
FeedlyというRSSリーダーから連携している構成があります。 Feedlyの …
-
-
AtomエディタでEC2のファイルを直接編集する
Webページを編集していてEC2のファイルをvimエディタでさわったりしています …
-
-
特定AWSアカウント特定リージョンのCloud9環境を削除するLambda(Python)
やりたいこと 特定アカウント内特定リージョン内のCloud9環境を全部削除したい …
-
-
よくあるサーバーレスアーキテクチャで質問フォーム
この記事はServerless2 Advent Calendar 2018に参加 …
-
-
新しいVPCウィザード(2022年)がすんごく便利になってました
VPCウィザードがすんごく便利になってました。 ウィザードの左ペインで設定を選択 …
-
-
AWS CloudWatch LogsエージェントでAmazon EC2上のNginxのaccess.log , error.log , php-fpm error.log , Linuxのmessages , secureログを収集する
参考ページ クイックスタート: 実行中の EC2 インスタンスに CloudWa …
-
-
AWS Lambda(Python)からAmazon Connectで電話を発信する
自動で電話を発信する必要がありまして、電話発信APIを開発することになりましたの …
-
-
AWS Service Catalogポートフォリオを他のアカウントと共有する
AWS Service Catalogチュートリアルで作成したポートフォリオの他 …
-
-
Amazon Glacierのプロビジョニングされた迅速取り出し容量をなぜか購入しました
過去1年ぐらいのAWSコストをCost Explorerで見てまして、10/10 …
-
-
AWSアカウントルートユーザーのMFAでYubicoセキュリティキーを設定した
先日Yubico セキュリティキーを購入して、USBにささなければならないのがな …